“Bu, responden saya cukup berapa?”
Pertanyaan ini hampir selalu muncul di pertemuan bimbingan pertama. Menariknya, jawabannya sering datang lebih cepat dari pertanyaannya. “Kata kakak tingkat, PLS-SEM cukup seratus, Bu.” Ada juga yang lebih yakin: “PLS-SEM kan memang untuk sampel kecil.”
Jawaban semacam itu tidak sepenuhnya keliru. Masalahnya, angka itu jarang datang bersama alasannya. Ia diwariskan dari skripsi ke skripsi, seperti resep keluarga yang tidak pernah ditanya asal-usulnya.
Padahal reviewer jurnal hari ini tidak lagi bertanya “berapa sampelnya”. Mereka bertanya “dari mana angka itu datang”. Dua pertanyaan yang terdengar mirip, tetapi menuntut jawaban yang berbeda.
Mari kita telusuri pelan-pelan, dari aturan praktis lama sampai perhitungan berbasis simulasi.
Aturan 10 kali: sederhana, dan kritiknya
Aturan ini diperkenalkan Barclay, Higgins, dan Thompson pada 1995. Cara kerjanya mudah diingat. Cari konstruk yang menerima panah terbanyak dalam model, lalu kalikan jumlah panah itu dengan sepuluh.
Misalkan variabel kinerja dipengaruhi tiga variabel lain. Maka sampel minimumnya 3 × 10 = 30 responden. Selesai, tanpa rumus, tanpa perangkat lunak.
Kesederhanaan inilah yang membuatnya bertahan hampir tiga dekade. Ia mirip mengukur panjang meja dengan jengkal tangan: cepat, praktis, dan cukup untuk perkiraan kasar. Tetapi tidak ada tukang kayu yang memotong papan hanya berdasarkan jengkal.
Kelemahannya terletak pada hal yang tidak dihitung. Aturan 10 kali tidak bertanya seberapa besar pengaruh yang ingin ditemukan, seberapa andal instrumennya, atau seberapa besar peluang penelitian itu berhasil mendeteksi sesuatu yang memang ada.
Kritik pun berdatangan. Marcoulides dan Saunders (2006) mempertanyakan anggapan bahwa PLS adalah “silver bullet” untuk sampel kecil. Goodhue, Lewis, dan Thompson (2012) melalui simulasi menunjukkan PLS tidak punya keunggulan khusus pada sampel kecil. Kock dan Hadaya (2018) kemudian membuktikan aturan ini cenderung menghasilkan angka yang terlalu rendah.
Hasilnya, Hair dan kolega dalam edisi ketiga Primer PLS-SEM (2022) tidak lagi menganjurkan aturan 10 kali sebagai dasar tunggal.
Bertanya pada Power
Lalu, alat ukur apa yang lebih tepat? Jawabannya ada pada satu konsep yang sering terlewat di bab metodologi: statistical power.
Power adalah peluang sebuah penelitian menemukan pengaruh yang memang ada. Bayangkan teropong bintang. Bintang yang terang terlihat dengan teropong kecil. Bintang yang redup butuh lensa yang lebih besar. Dalam penelitian, bintang redup itu adalah pengaruh yang kecil, dan lensa yang lebih besar adalah ukuran sampel yang lebih besar.
Cohen (1992) menetapkan konvensi yang masih dipakai hingga kini: power 80%. Artinya, jika pengaruh itu memang ada, penelitian kita punya peluang 8 dari 10 untuk menemukannya.
Dari konsep ini lahir dua cara yang lebih jujur dibanding aturan 10 kali.
Tabel Cohen dalam Primer Hair dkk. Peneliti cukup menentukan empat hal: jumlah panah terbanyak ke satu konstruk, R² terkecil yang ingin dideteksi, taraf signifikansi, dan power 80%. Angka sampel minimum lalu dibaca langsung dari tabel. Cara ini ramah bagi mahasiswa karena tidak perlu perangkat lunak.
G*Power. Perangkat lunak gratis dari Faul dan kolega (2009) ini menghitung sampel minimum secara lebih fleksibel. Pengaturan yang lazim dipakai untuk PLS-SEM adalah F tests, linear multiple regression: fixed model, R² deviation from zero, dengan ukuran efek f² = 0,15 (efek sedang), α = 0,05, dan power 0,80. Jumlah prediktor diisi dengan jumlah panah terbanyak ke satu konstruk.
| Jumlah prediktor | Sampel minimum |
|---|---|
| 2 | 68 |
| 3 | 77 |
| 4 | 85 |
| 5 | 92 |
Kembali ke contoh tadi. Model dengan tiga panah ke variabel kinerja butuh 30 responden menurut aturan 10 kali, tetapi 77 responden menurut G*Power. Selisihnya lebih dari dua kali lipat. Di situlah letak masalah jengkal tangan.
Dari koefisien jalur terkecil
Tabel Cohen dan G*Power sebenarnya meminjam logika regresi. Kock dan Hadaya (2018) lalu mengajukan cara yang lebih dekat dengan cara kerja PLS-SEM itu sendiri: metode akar kuadrat terbalik (inverse square root method).
Logikanya kembali ke teropong. Besar lensa ditentukan oleh bintang teredup yang ingin kita lihat. Dalam model PLS-SEM, bintang teredup itu adalah koefisien jalur terkecil yang kita harapkan signifikan (p_min). Rumusnya, untuk α = 5% dan power 80%:
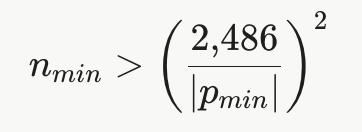
Konstanta 2,486 diganti 3,168 untuk α = 1%, dan 2,123 untuk α = 10%.
| Koefisien jalur terkecil (p_min) | Sampel minimum (α = 5%) |
|---|---|
| 0,05–0,10 | 619 |
| 0,11–0,20 | 155 |
| 0,21–0,30 | 69 |
| 0,31–0,40 | 39 |
Tabel ini membuka satu kenyataan yang jarang disadari. Semakin kecil pengaruh yang ingin dibuktikan, semakin mahal harganya. Pengaruh sebesar 0,1 butuh lebih dari 600 responden, bukan 100.
Dari mana angka p_min diambil? Idealnya dari penelitian terdahulu dengan model serupa, bukan tebakan. Jika acuan itu tidak tersedia, rentang 0,11–0,20 (155 responden) lazim dipakai sebagai asumsi yang hati-hati. Metode ini kini diadopsi dalam Primer Hair dkk. (2022).
Untuk yang ingin lebih presisi, ada dua jalan lanjutan. Pertama, metode gamma-exponential dari Kock dan Hadaya (2018), yang hasilnya sedikit lebih kecil dan sudah tersedia otomatis di WarpPLS. Kedua, simulasi Monte Carlo: peneliti menyusun model dengan parameter yang diasumsikan, lalu mensimulasikan ribuan sampel untuk melihat pada ukuran berapa power mencapai 80% (Wolf dkk., 2013). Cara kedua ini memberi hasil yang lebih teliti untuk model rumit seperti moderasi bertingkat atau konstruk orde tinggi, meski butuh kemampuan pemrograman.
Slovin menjawab pertanyaan yang lain
Lalu bagaimana dengan rumus Slovin atau tabel Krejcie dan Morgan (1970) yang akrab di skripsi kita? Keduanya tidak salah, hanya menjawab pertanyaan yang berbeda.
Bayangkan mencicipi sayur asem. Satu sendok sudah cukup untuk menilai rasa sepanci, asalkan sayurnya diaduk rata. Yang menentukan bukan besar sendoknya, melainkan apakah isi panci tercampur dengan baik. Rumus berbasis populasi bekerja dengan logika ini: ia bertanya apakah sampel mewakili populasinya.
Power bertanya hal lain: apakah sampel cukup kuat untuk mendeteksi pengaruh yang dicari. Sampel yang mewakili belum tentu kuat, dan sampel yang kuat belum tentu mewakili.
Karena itu, rumus Slovin tidak bisa berdiri sendiri sebagai dasar ukuran sampel PLS-SEM. Memon dan kolega (2020) dalam tinjauan mereka tentang ukuran sampel penelitian survei secara khusus mengingatkan bahwa rumus Slovin kerap disalahgunakan dalam penelitian SEM. Rumus berbasis populasi tetap berguna, tetapi sebagai pelengkap, terutama bila populasinya jelas dan terbatas.
Dua pertanyaan, bukan satu
Setelah menelusuri semua cara di atas, terlihat bahwa “berapa responden yang cukup” sebenarnya menyimpan dua pertanyaan. Pertama, apakah sampel cukup kuat untuk menemukan pengaruh yang dicari? Kedua, apakah sampel cukup mewakili populasinya? Yang pertama dijawab oleh analisis power, yang kedua oleh teknik sampling.
Dari situ, ada beberapa kebiasaan yang layak dibangun dalam menulis bab metodologi:
- Gunakan minimal dua metode berbasis power yang saling menguatkan, misalnya G*Power dan akar kuadrat terbalik, lalu ambil angka yang lebih besar.
- Tuliskan argumen keterwakilan secara terpisah, lewat penjelasan teknik sampling yang dipakai.
- Hindari kalimat “PLS-SEM cocok untuk sampel kecil” tanpa batasan. Hair dan kolega (2019) menegaskan bahwa PLS-SEM tetap butuh sampel yang memadai secara power. Reinartz, Haenlein, dan Henseler (2009) menemukan sekitar 100 observasi sebagai titik awal power yang dapat diterima.
- Siapkan cadangan 10–20% untuk mengantisipasi respons yang tidak valid atau outlier.
Angka sampel, pada akhirnya, bukan mantra yang diwariskan. Ia adalah argumen yang perlu dipertanggungjawabkan.
Jadi, ketika pertanyaan “responden saya cukup berapa, Bu?” muncul lagi di ruang bimbingan, barangkali jawaban yang lebih jujur justru sebuah pertanyaan balik: pengaruh sebesar apa yang ingin kamu temukan?
Referensi
Barclay, D., Higgins, C., & Thompson, R. (1995). The partial least squares (PLS) approach to causal modeling: Personal computer adoption and use as an illustration. Technology Studies, 2(2), 285–309.
Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159.
Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160.
Goodhue, D. L., Lewis, W., & Thompson, R. (2012). Does PLS have advantages for small sample size or non-normal data? MIS Quarterly, 36(3), 981–1001.
Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). Sage.
Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24.
Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28(1), 227–261.
Krejcie, R. V., & Morgan, D. W. (1970). Determining sample size for research activities. Educational and Psychological Measurement, 30(3), 607–610.
Marcoulides, G. A., & Saunders, C. (2006). PLS: A silver bullet? MIS Quarterly, 30(2), iii–ix.
Memon, M. A., Ting, H., Cheah, J.-H., Thurasamy, R., Chuah, F., & Cham, T. H. (2020). Sample size for survey research: Review and recommendations. Journal of Applied Structural Equation Modeling, 4(2), i–xx.
Reinartz, W., Haenlein, M., & Henseler, J. (2009). An empirical comparison of the efficacy of covariance-based and variance-based SEM. International Journal of Research in Marketing, 26(4), 332–344.
Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934.